
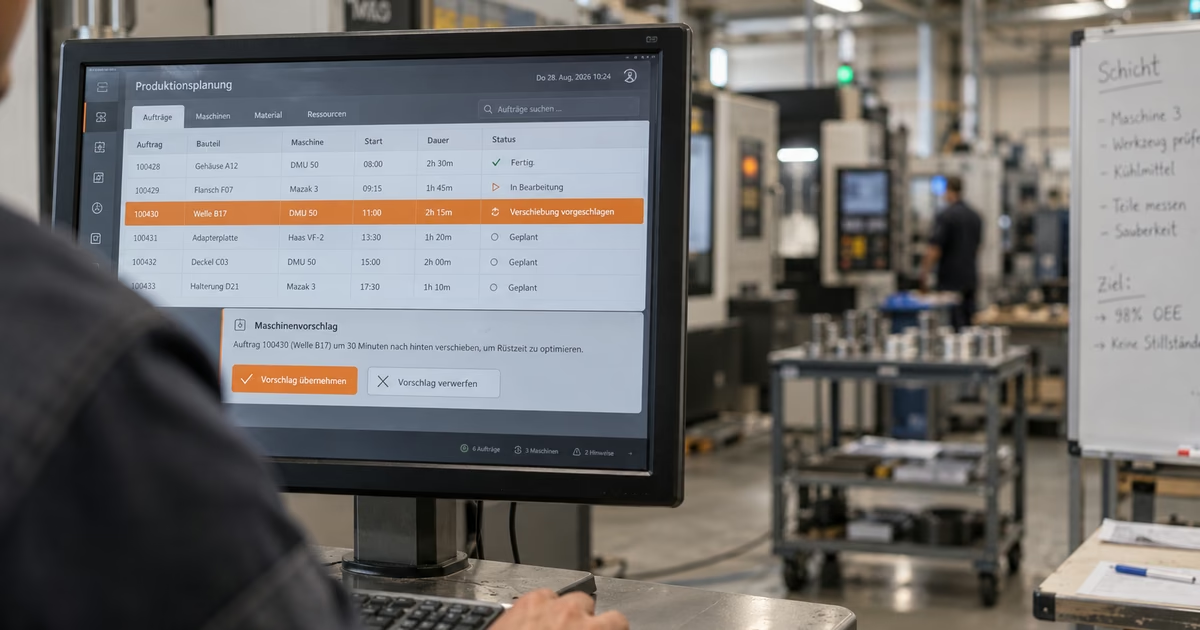
Das wichtigste auf einen Blick:
KI-Integration in bestehende Systeme ist keine reine Schnittstellenfrage. Sie ist die Festlegung einer Eingriffstiefe. Ob eine KI nur liest, in ein Nebensystem schreibt, im Kernsystem Vorschläge macht oder selbst bucht, entscheidet über Datenvoraussetzung, Freigabelogik, Protokollierung und Rückrollpfad. Der Weg der Anbindung folgt aus dieser Entscheidung, nicht umgekehrt.
In mittelständischen Fertigungsbetrieben verläuft es oft so. Das Modell lief sechs Wochen im Testbetrieb, und es lief gut. Es las die Rückmeldedaten aus dem MES, verglich sie mit den Plandaten im ERP und erkannte zuverlässig, welche Arbeitsgänge regelmäßig länger dauerten als geplant. Der Fertigungsleiter war überzeugt. Dann kam die Frage, was das System eigentlich tun sollte, wenn es eine Abweichung erkennt. Nicht berichten. Handeln. Einen Auftrag verschieben, einen Termin ändern, Material umbuchen.
An dieser Stelle stand das Projekt still, und zwar nicht aus technischen Gründen. Die Schnittstelle war vorhanden, das ERP hätte die Buchung entgegengenommen. An der Technik lag es nicht. Was fehlte, war eine Antwort auf die Frage, wer diese Buchung verantwortet und wie man sie wieder herausbekommt, wenn sie falsch war.
Dieser Moment ist keine Ausnahme, und er hat wenig mit der Reife der Künstlichen Intelligenz zu tun. In der Erhebung des Statistischen Bundesamts für 2025 nennen 45 Prozent der deutschen Unternehmen ab zehn Beschäftigten, die den Einsatz von KI erwogen, aber bisher nicht umgesetzt haben, die Inkompatibilität mit dem Bestand an Geräten, Software und Systemen als Grund. Das ist der vierthäufigste Hinderungsgrund, noch vor Datenqualität und deutlich vor Kosten. Bei kleineren und mittleren Unternehmen liegt der Wert bei 46 Prozent, bei Unternehmen ab 250 Beschäftigten bei 38.
Die Erfahrung aus unseren Projekten ist: Die Schnittstelle ist selten das Problem. Entschieden wird, wie tief die KI eingreifen darf.
Was KI-Integration bedeutet, und was sie von KI-Implementierung unterscheidet
KI-Integration bezeichnet die technische und organisatorische Ankopplung eines Systems der Künstlichen Intelligenz an die bestehende IT eines Unternehmens, also an ERP, MES, WMS, CRM oder Maschinensteuerungen. Sie legt drei Dinge fest: welche Daten fließen, in welche Richtung sie fließen und welche Handlungen das System in den angebundenen Systemen auslösen darf.
Damit ist sie etwas anderes als KI-Implementierung. Implementierung beschreibt die Einführung eines KI-Vorhabens als Projekt, von der Zieldefinition über Datenaufbereitung und Pilotbetrieb bis zum Rollout. Welche Stolpersteine dabei typischerweise auftreten, haben wir an anderer Stelle beschrieben, in unserem Beitrag zur KI-Implementierung in der Praxis. Integration ist der engere, technischere Ausschnitt daraus. Ein Vorhaben kann sauber implementiert und trotzdem falsch gekoppelt sein.
Der Unterschied wird praktisch, sobald das System nicht mehr nur auswertet. Solange eine KI liest, ist Integration eine Frage von Zugriffsrechten und Datenqualität. Sobald sie in ein Kernsystem zurückschreibt, wird sie eine Frage von Verantwortung.
Vier Kopplungsgrade: wie tief eine KI in bestehende Systeme eingreift
Die Schnittstelle ist die Voraussetzung. Entschieden wird die Eingriffstiefe. Aufsichtsgrade über automatisierte Systeme sind dabei nichts Neues.
Die von der Europäischen Kommission eingesetzte Expertengruppe für Künstliche Intelligenz hat 2019 drei davon beschrieben. Bei human-in-the-loop kann ein Mensch in jedem Entscheidungszyklus eingreifen. Human-on-the-loop meint den Eingriff während der Entwurfsphase, danach nur noch die laufende Überwachung des Betriebs. Human-in-command bezeichnet die Aufsicht über die Gesamtaktivität des Systems. Abgestufte Modelle dieser Art sind in der Forschung zur Mensch-Automatisierung-Interaktion seit Langem beschrieben, unter anderem bei Parasuraman, Sheridan und Wickens.
Auf die Systemlandschaft in Industrie und Produktion übersetzt, ergeben sich vier Kopplungsgrade.
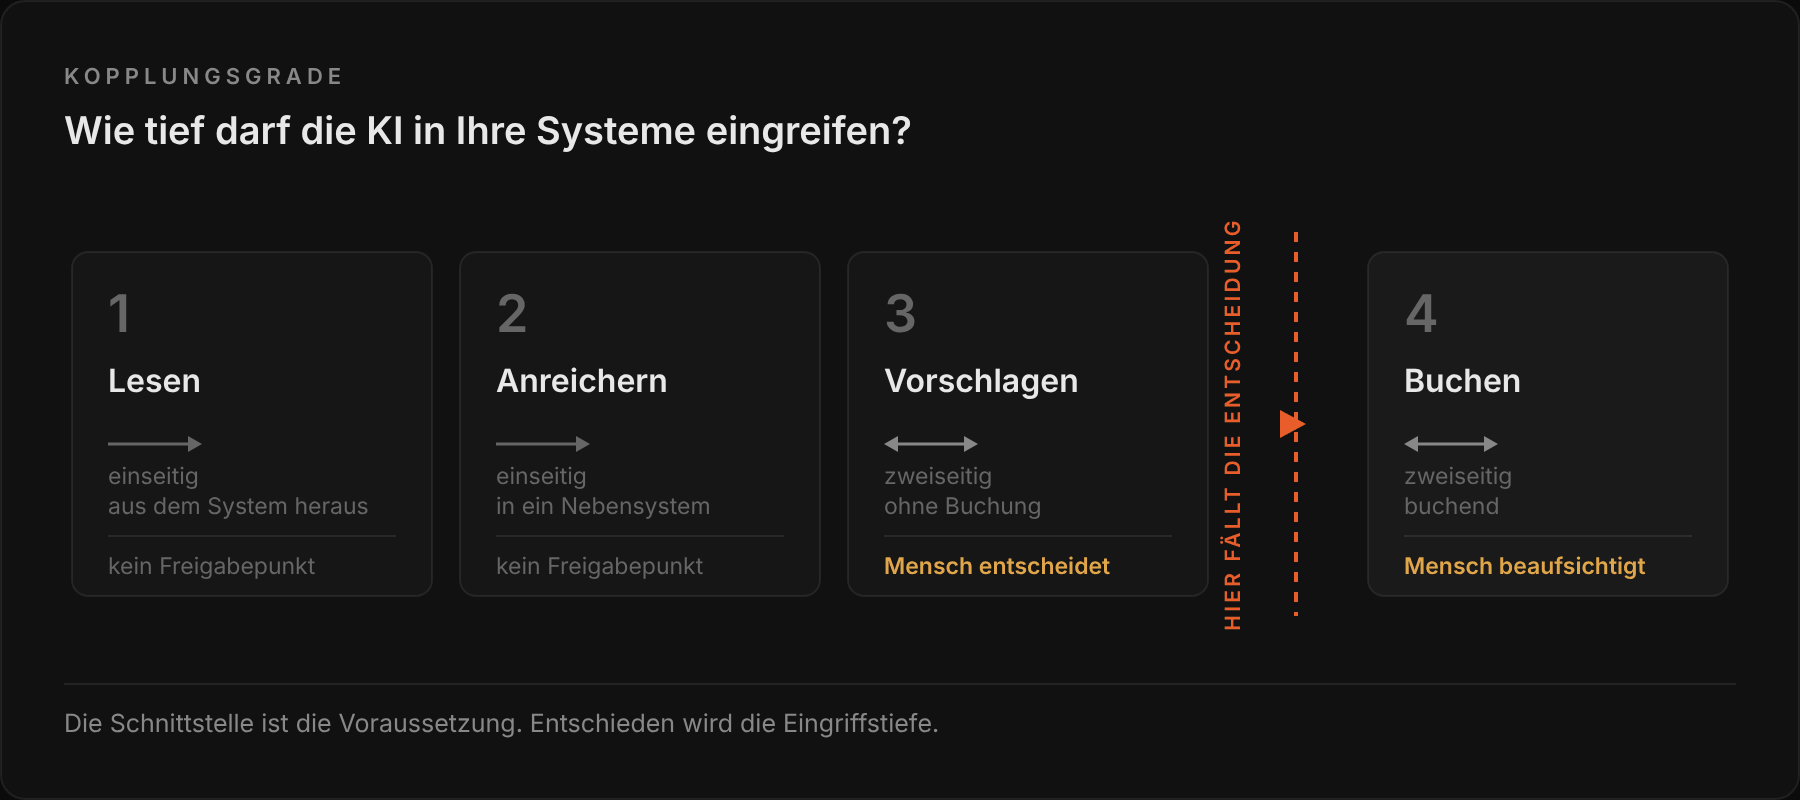
Sie unterscheiden sich nicht darin, wie gut das Modell ist, sondern darin, was es im angebundenen System bewirken darf.
Kopplungsgrad 1: Die KI liest aus ERP und MES
Das System bekommt lesenden Zugriff auf Plandaten aus dem ERP und Rückmeldedaten aus dem MES. Es wertet aus und berichtet. Im Beispiel der Produktionsplanung erkennt es, dass ein bestimmter Arbeitsgang auf einer bestimmten Maschinengruppe systematisch über der hinterlegten Vorgabezeit liegt.
Voraussetzung ist Historie. Ein Modell, das nur die letzten Wochen kennt, unterscheidet keinen Trend von einem Ausreißer. Die Schnittstelle ist einseitig, das Risiko gering, die Aufsicht beschränkt sich darauf, dass jemand die Ergebnisse überhaupt liest. Wer hier startet, hat nicht klein gedacht. Er hat sauber abgegrenzt.
Menge allein reicht allerdings nicht. Woran sich Datenqualität festmachen lässt, ist beschrieben: Der Praxisleitfaden zur Datenaufbereitung des Fraunhofer-Instituts für Gießerei-, Composite- und Verarbeitungstechnik IGCV fasst die Güte von Daten als Genauigkeit, Vollständigkeit, Konsistenz und Aktualität und nennt zusätzlich die Relevanz als Auswahlkriterium. Diese fünf Begriffe klingen nach Lehrbuch und werden im Betrieb sehr schnell konkret. Eine Rückmeldung, die der Werker erst am Ende der Schicht sammelt, ist vollständig und trotzdem nicht aktuell. Eine Vorgabezeit, die in zwei Systemen unterschiedlich gepflegt ist, ist genau und trotzdem inkonsistent.
Schlechte Daten sind dabei teurer als keine Daten. Das ist unsere Einschätzung aus der Projektarbeit, und sie hat einen einfachen Grund: Wo Daten fehlen, meldet das System eine Lücke, und jemand entscheidet bewusst. Wo Daten falsch sind, rechnet es weiter und liefert ein Ergebnis, dem niemand ansieht, dass es nicht stimmt.
Der Kopplungsgrad entscheidet darüber, was eine solche Lücke anrichtet. Auf Grad 1 führt sie zu einer Auswertung, der jemand widerspricht. Auf Grad 4 führt dieselbe Lücke zu einer Buchung, die jemand zurücknehmen muss. Deshalb ist die Datenlage keine Vorstufe, die man vor dem eigentlichen Vorhaben abhakt. Sie ist der Grund, warum ein Vorhaben auf einer bestimmten Stufe bleibt.
Und noch etwas beginnt bereits auf dieser Stufe, obwohl das System nur liest. Rückmeldedaten aus dem MES sind selten anonym. An einem gebuchten Arbeitsgang hängt in aller Regel, wer ihn gebucht hat. Damit ist die Auswertung eine Verarbeitung personenbezogener Daten, und Daten, die für die Auftragsabwicklung erhoben wurden, werden hier für einen anderen Zweck verwendet. Die Orientierungshilfe der Datenschutzkonferenz zu KI-Systemen vom Juni 2025 verlangt, den Zweck des KI-Systems festzulegen, bevor bereits erhobene Daten weitergenutzt werden. Für den Rücklauf ist sie noch deutlicher: Die Verarbeitung von personenbezogenen Ein- oder Ausgaben zum weiteren Training eines Modells stuft sie ausdrücklich als zweckändernde Weiterverarbeitung ein. Wer also plant, die Bestätigungen und Korrekturen der Planer später zurück ins Modell zu geben, trifft damit eine datenschutzrechtliche Entscheidung und keine technische. Sie gehört an den Anfang, weil sie sich nachträglich nur schwer heilen lässt.
Kopplungsgrad 2: Die KI schreibt in ein Nebensystem
Dieselbe Auswertung schreibt jetzt, aber nicht ins Kernsystem. Die erkannte Abweichung landet als Kennzahl in einem Berichtssystem oder Dashboard, neben den Zahlen, mit denen die Planer ohnehin arbeiten. Das ERP bleibt unberührt.
Damit steigt der Anspruch an die Nachvollziehbarkeit. Wenn eine Kennzahl im Dashboard steht, muss erkennbar sein, woher sie stammt und wie alt sie ist, sonst konkurriert sie mit den Zahlen daneben, statt sie zu ergänzen. Genau das ist das typische Scheitern auf dieser Stufe: Das Modell rechnet richtig, und trotzdem entstehen zwei Wahrheiten. Die Planung rechnet mit der Vorgabezeit aus dem ERP, die KI zeigt einen abweichenden Erfahrungswert, und niemand hat festgelegt, welche der beiden Zahlen in der Besprechung gilt.
Die Abhilfe ist unspektakulär und wird trotzdem oft übersprungen: Jede abgeleitete Kennzahl bekommt einen fachlichen Eigentümer, einen dokumentierten Rechenweg und einen Zeitstempel. Die Frage, wo solche Werte technisch sinnvollerweise liegen, führt direkt in die Architektur der Datenhaltung, die wir im Vergleich von Data Warehouse und Data Lake behandelt haben.
Kopplungsgrad 3: Die KI schlägt im Kernsystem vor
Der Vorschlag wird im Kernsystem sichtbar. Die KI markiert im Planungssystem eine geänderte Auftragsreihenfolge, erkennbar als Vorschlag, nicht als Plan. Der Fertigungsplaner bestätigt oder verwirft.
Auf dieser Stufe entspricht die Aufsicht dem, was die Expertengruppe der Europäischen Kommission als Eingriff in jedem Entscheidungszyklus beschreibt, also human-in-the-loop. Und hier entstehen die ersten Fragen, die keine IT-Fragen mehr sind. Wer darf bestätigen? Was passiert mit einem Vorschlag, den niemand ansieht, weil der zuständige Planer im Urlaub ist? Verfällt er, oder bleibt er stehen und wird in drei Wochen versehentlich übernommen?
Die Schnittstelle ist jetzt zweiseitig, aber sie bucht nicht. Das ist eine belastbare Zielstufe, kein Zwischenschritt. Viele Betriebe fahren dauerhaft und gut auf Grad 3, und in einigen Fällen ist das die bewusst bessere Entscheidung: Der Planer bringt Kontextwissen ein, das in keinem System steht, etwa die Zusage an einen Kunden, von der nur er weiß. Ein System, das ihm die Reihenfolge vorschlägt, macht ihn schneller. Ein System, das sie ihm abnimmt, macht ihn zum Nachprüfer.
Kopplungsgrad 4: Die KI bucht selbst
Das System verschiebt Fertigungsaufträge selbst, ändert Termine im ERP, reserviert Material. Ein Mensch prüft nicht mehr jeden einzelnen Vorgang. Er beaufsichtigt das Verhalten des Systems insgesamt. Das entspricht dem, was die Expertengruppe human-on-the-loop nennt.
Auf Kopplungsgrad 4 hört Integration auf, ein IT-Thema zu sein. Wenn die KI einen Auftrag vorzieht, für den das Material erst in zwei Wochen eintrifft, ist das kein Datenproblem. Es ist ein gerissener Kundentermin. Auch sicherheitstechnisch ist das ein anderes Ereignis: Ein schreibender Zugang ist mehr als ein erweiterter Lesezugang. Es ist ein Konto, das im Zielsystem Zustände verändern kann, und es gehört entsprechend eng vergeben und überwacht. Vier Dinge müssen deshalb vorher stehen: ein Ausgangswert, gegen den Wirkung gemessen wird, eine Kennzahl, die das Ziel beschreibt, eine Definition dessen, was als Ausnahmefall gilt, und ein Weg zurück. Wer den Ausnahmefall nicht benennen kann, kann ihn nicht eskalieren. Dann ist Grad 3 die richtige Stufe.
Systeme, die auf dieser Stufe selbstständig handeln, sind das, was wir an anderer Stelle als KI-Agenten beschrieben haben.
| GRAD | WAS DIE KI TUT | WORAN SIE IHRE STUFE ERKENNEN | DATENVORAUSSETZUNG | AUFSICHT | RÜCKROLLBEDARF |
|---|---|---|---|---|---|
| Grad 1 | liest und berichtet | Ergebnisse landen in einem Bericht, den jemand liest | ausreichende Historie | niemand muss eingreifen | keiner |
| Grad 2 | schreibt in ein Nebensystem | eine Kennzahl steht im Dashboard neben den Planzahlen | Zielsystem, Herkunftsnachweis | niemand muss eingreifen | Kennzahl korrigierbar |
| Grad 3 | schlägt im Kernsystem vor | im Planungssystem steht ein Vorschlag, den jemand bestätigt | Rollen- und Freigabeklarheit | Mensch entscheidet jeden Fall | Vorschlag verwerfen |
| Grad 4 | bucht im Kernsystem | eine Buchung entsteht, ohne dass jemand sie ausgelöst hat | Baseline, KPI, definierter Ausnahmefall | Mensch beaufsichtigt das Verhalten | vollständig, inklusive Folgebuchungen |
Wenn Sie an dieser Stelle wissen, auf welcher Stufe Ihr Vorhaben landen soll, ist die Hälfte der Entscheidung gefallen. Die andere Hälfte ist die Frage, was in Ihrem Betrieb dafür schon steht und was nicht. Darüber sprechen wir in einem kostenlosen Erstgespräch. 30 Minuten. Unverbindlich. Konkret.
Fünf Wege, KI an bestehende Systeme anzubinden
Erst wenn die Eingriffstiefe feststeht, wird die Wegewahl beantwortbar. Denn nicht jeder Anbindungsweg trägt jeden Grad, und welcher überhaupt infrage kommt, hängt am Zustand der vorhandenen IT-Systeme. Die Wahl der richtigen Architektur ist für eine erfolgreiche KI-Integration entscheidend, und sie lässt sich an einer einzigen Größe messen: daran, wie viel vom Bestand bei einer Änderung mitbewegt werden muss. Modulare und API-getriebene Ansätze minimieren das Risiko von Systemausfällen, weil eine Anbindung über eine dokumentierte Schnittstelle das Zielsystem unverändert lässt und im Störfall einzeln abgeschaltet werden kann. Ein Eingriff in den Systemkern kann das nicht. Er fällt mit dem System aus, das er verändert.
Die Herstellerfunktion im vorhandenen System. Viele ERP-, CRM- und Dokumentensysteme liefern inzwischen eigene KI-Funktionen mit. Wer damit auskommt, steht vor einer Konfigurationsaufgabe und nicht vor einem Integrationsprojekt. Das ist der günstigste Weg und der erste, den man prüfen sollte, auch wenn die Prüfung unbequem ist: Sie endet regelmäßig damit, dass eine Funktion bereits im Lizenzumfang steckt und nur nicht aktiviert wurde. Die Grenze der Herstellerfunktion liegt dort, wo mehrere Systeme zusammenspielen müssen, denn sie sieht nur die Daten ihres eigenen Systems. Wo eine KI-Lösung in der Systemlandschaft überhaupt sitzen kann, haben wir im Überblick zu KI-Lösungen für Unternehmen in vier Ebenen geordnet.
Die direkte Anbindung über die Programmierschnittstelle. Das KI-System spricht per REST- oder SOAP-Schnittstelle unmittelbar mit dem Zielsystem. Kurze Wege, wenige Bauteile. Der Preis ist die Bindung: Jede Schnittstelle ist eine Stelle, die bei einem Systemwechsel oder einem größeren Versionssprung nachgezogen werden muss. Bei einer Handvoll Anbindungen ist das überschaubar. Bei zwanzig nicht mehr.
Middleware oder eine Integrationsplattform. Zwischen KI und Zielsystemen liegt eine Schicht, die Formate übersetzt, Aufrufe puffert und Fehler abfängt. Der Aufwand ist höher, der Betrieb dafür stabiler, und die Zahl der Punkte, an denen etwas nachgezogen werden muss, sinkt. Der praktische Gewinn zeigt sich weniger im Normalbetrieb als im Störfall: Wenn das ERP für ein Wartungsfenster nicht erreichbar ist, laufen direkte Aufrufe ins Leere, während eine Zwischenschicht sie hält und nachfährt.
Eine Steuerungsschicht über den Systemen. Sie übernimmt zusätzlich zur Übersetzung die Freigabelogik, die Protokollierung und die Wirkungsmessung. Das ist der Weg, den Grad 3 und 4 tatsächlich verlangen, weil dort Entscheidungen fallen und nicht nur Daten fließen. Unsere Plattform AIOP setzt genau an dieser Stelle an, oberhalb der bestehenden Systeme, ohne sie zu ersetzen.
Die Eigenentwicklung. Sinnvoll, wenn der Prozess wirklich einzigartig ist. In den meisten Fällen ist er das nicht, und die Eigenentwicklung erzeugt die Wartungslast, die man mit der Integration eigentlich vermeiden wollte.
Bemerkenswert ist, was auf dieser Liste fehlt: die Modifikation des ERP-Kerns. Das ist keine Beraterposition, sondern die dokumentierte Empfehlung des Herstellers selbst. SAP fasst seinen Clean-Core-Ansatz für S/4HANA Cloud so zusammen, dass der Kern standardnah und upgrade-stabil bleiben soll; Erweiterungen laufen entweder entkoppelt auf der eigenen Plattform oder als upgrade-stabile Erweiterung im System. Modifikationen am Kern ordnet SAP der niedrigsten der vier Compliance-Stufen zu und empfiehlt sie nicht. Als problematisch benennt der Hersteller ausdrücklich individuellen Code, undokumentierte Änderungen und schwer wartbare Integrationen. Diese Einordnung stammt von SAP und gilt formal für S/4HANA Cloud. Auf andere ERP-Systeme lässt sie sich nicht ungeprüft übertragen, die Richtung der Empfehlung ist aber deutlich.
Für Maschinen- und Sensordaten gilt eine eigene Logik. Mit OPC UA existiert dort ein Standard, der laut der Spezifikation der OPC Foundation für Komponenten in allen industriellen Bereichen anwendbar ist, von Sensoren und Aktoren über Steuerungssysteme bis zu Manufacturing Execution Systems. Sein Kern ist ein Informationsmodell, das Struktur, Verhalten und Semantik abbildet, ergänzt um ein Sicherheitsmodell für die Authentifizierung von Clients, Servern und Nutzern. Das ist der Unterschied zu einer typischen ERP-Schnittstelle, die Felder liefert, aber nicht deren Bedeutung.
| WEG | VORAUSSETZUNG | TRÄGT WELCHEN GRAD | BETRIEBSLAST | TYPISCHES FEHLERBILD |
|---|---|---|---|---|
| Herstellerfunktion im System | Funktion im Lizenzumfang enthalten | 1 bis 2, systemintern auch 3 | gering | sieht nur die Daten des eigenen Systems |
| Direkte API-Anbindung | dokumentierte Schnittstelle im Zielsystem | 1 bis 4 | mittel | jede Schnittstelle muss beim Versionssprung nachgezogen werden |
| Middleware oder Integrationsplattform | Betrieb einer Zwischenschicht | 1 bis 4 | mittel bis hoch | Aufwand vorne, Stabilität hinten |
| Steuerungsschicht über den Systemen | Freigabe, Protokoll, Messung als Teil des Umfangs | 3 und 4 | hoch, dafür an einer Stelle | wird zu früh gewählt, wenn Grad 1 genügt |
| Eigenentwicklung | wirklich einzigartiger Prozess | 1 bis 4 | dauerhaft hoch | erzeugt die Wartungslast, die vermieden werden sollte |
Was tun, wenn das Zielsystem alt ist
Die fünf Wege setzen stillschweigend voraus, dass das Zielsystem eine brauchbare Schnittstelle hat. In gewachsenen IT-Landschaften stimmt das oft nicht. Viele Unternehmen betreiben Fertigungssteuerungen, Warenwirtschaften oder Prüfsysteme, die seit fünfzehn oder zwanzig Jahren laufen, ihren Zweck erfüllen und keinen Anlass zur Ablösung geben. Im Fachjargon heißen sie Legacy-Systeme, was nach Ballast klingt und meist einfach bedeutet, dass sie funktionieren. Genau diese Systeme halten die Daten, die eine Künstliche Intelligenz braucht.
Bei solchen Legacy-Systemen treten zwei Herausforderungen zusammen auf. Erstens fehlt häufig eine standardisierte Schnittstelle. Statt einer dokumentierten Programmierschnittstelle gibt es einen Datenbankzugriff, einen Dateiexport zu festen Zeiten oder im ungünstigsten Fall eine Bildschirmmaske. Zweitens ist die Datenkompatibilität eingeschränkt, weil Formate, Zeichensätze und Schlüssellogiken aus einer Zeit stammen, in der niemand an eine spätere Auswertung gedacht hat.
Beides ist lösbar, aber es verschiebt den Aufwand, und zwar in eine Richtung, die viele Angebote unterschätzen. Bei Legacy-Integrationen wandert ein erheblicher Teil des Budgets weg von Modell und Schnittstelle hin zur Datenbereinigung, also zum Vereinheitlichen von Schlüsseln, zum Auflösen historischer Sonderfälle und zum Nachziehen von Feldern, die jahrelang unterschiedlich gepflegt wurden. Wo eine moderne Schnittstelle fehlt, übernimmt eine Zwischenschicht die Übersetzung, und sie fängt zugleich ab, dass ein Legacy-System für Wartungsfenster oder Tagesabschlüsse nicht erreichbar ist. Der Preis ist ein zusätzliches Stück Infrastruktur, das betrieben werden will.
Für die Kopplungsgrade hat das eine praktische Folge, die den Blick auf das ganze Vorhaben verändert. Aus einem Altsystem zu lesen ist fast immer möglich, notfalls über einen nächtlichen Export. Diese Möglichkeit fehlt selten. In ein Altsystem zu schreiben ist dagegen die Stelle, an der Vorhaben scheitern: Ohne dokumentierte Schnittstelle gibt es keine verlässliche Rückmeldung darüber, ob eine Buchung angekommen ist, und ohne diese Rückmeldung trägt kein Rückrollpfad. Unsere Einschätzung aus der Projektarbeit: Wo das Zielsystem alt ist, ist Kopplungsgrad 3 die technisch saubere Wahl und nicht die vorsichtige.
Cloud-Dienste ändern an dieser Rechnung weniger, als ihre Anbieter nahelegen. Sie machen die Modellseite elastisch, also Rechenleistung, Speicher und das Aufsetzen weiterer Anwendungsfälle. Der Engpass liegt auf der anderen Seite. Ob eine Buchung im Altsystem ankommt und wie sie sich zurücknehmen lässt, entscheidet dieses System, unabhängig davon, wo das Modell rechnet.
Wo dieses System und die Zwischenschicht davor betrieben werden, ist wiederum eine eigene Entscheidung. On-Premise, in der Cloud oder hybrid entscheidet sich daran, wo die Daten liegen dürfen und wer die Infrastruktur nachts betreut. Mit Mode hat das wenig zu tun.
Wenn das System selbst handelt
Wenn KI-Systeme selbst handeln sollen, wird die Rückfrage zur Protokollfrage. Die Spezifikation des Model Context Protocol vom 28. Juli 2026 führt serverseitig ausgelöste Rückfragen, etwa Bestätigungen oder fehlende Parameter, ausdrücklich als Schlüsselfunktion für interaktive Agentenabläufe. Das ist eine junge Spezifikation ohne Normstatus, und bemerkenswert ist weniger ihr Verbreitungsgrad als die Richtung: Ob ein System selbst handeln darf oder rückfragen muss, wird inzwischen auf der Protokollebene entschieden.
Was ab Kopplungsgrad 3 im Betrieb stehen muss
Vier Dinge entscheiden darüber, ob eine Kopplung ab Grad 3 trägt. Keines davon ist eine Frage der Schnittstelle.
Freigabe. Wer bestätigt, in welchem Zeitfenster, und was geschieht, wenn niemand bestätigt. Ein Vorschlag ohne Verfallslogik ist eine Zeitbombe im Planungssystem. Eine tragfähige Regel klärt, welche Rolle freigeben darf, welche Vertretung bei Abwesenheit greift, nach welcher Frist ein Vorschlag ungenutzt verfällt und ab welchem Umfang eine zweite Freigabe nötig ist. Die Umfangsgrenze wird dabei am häufigsten vergessen und wirkt am stärksten, weil sie kleine Routinefälle durchlaufen lässt und große anhält. Diese Regeln müssen vor dem ersten Produktivlauf stehen, nicht nach dem ersten Zwischenfall.
Protokollierung. Welche Eingabedaten lagen vor, welche Handlung wurde ausgelöst, wer hat sie freigegeben, wann. Das klingt nach Bürokratie und ist die Voraussetzung dafür, eine Entscheidung im Nachhinein überhaupt erklären zu können. Wer sie nicht erklären kann, wird sie beim ersten Streitfall zurücknehmen müssen, ohne zu wissen, was genau er zurücknimmt. Wie sich Zuständigkeiten und Regeln für Datennutzung sauber ordnen lassen, zeigt unser Data-Governance-Framework.
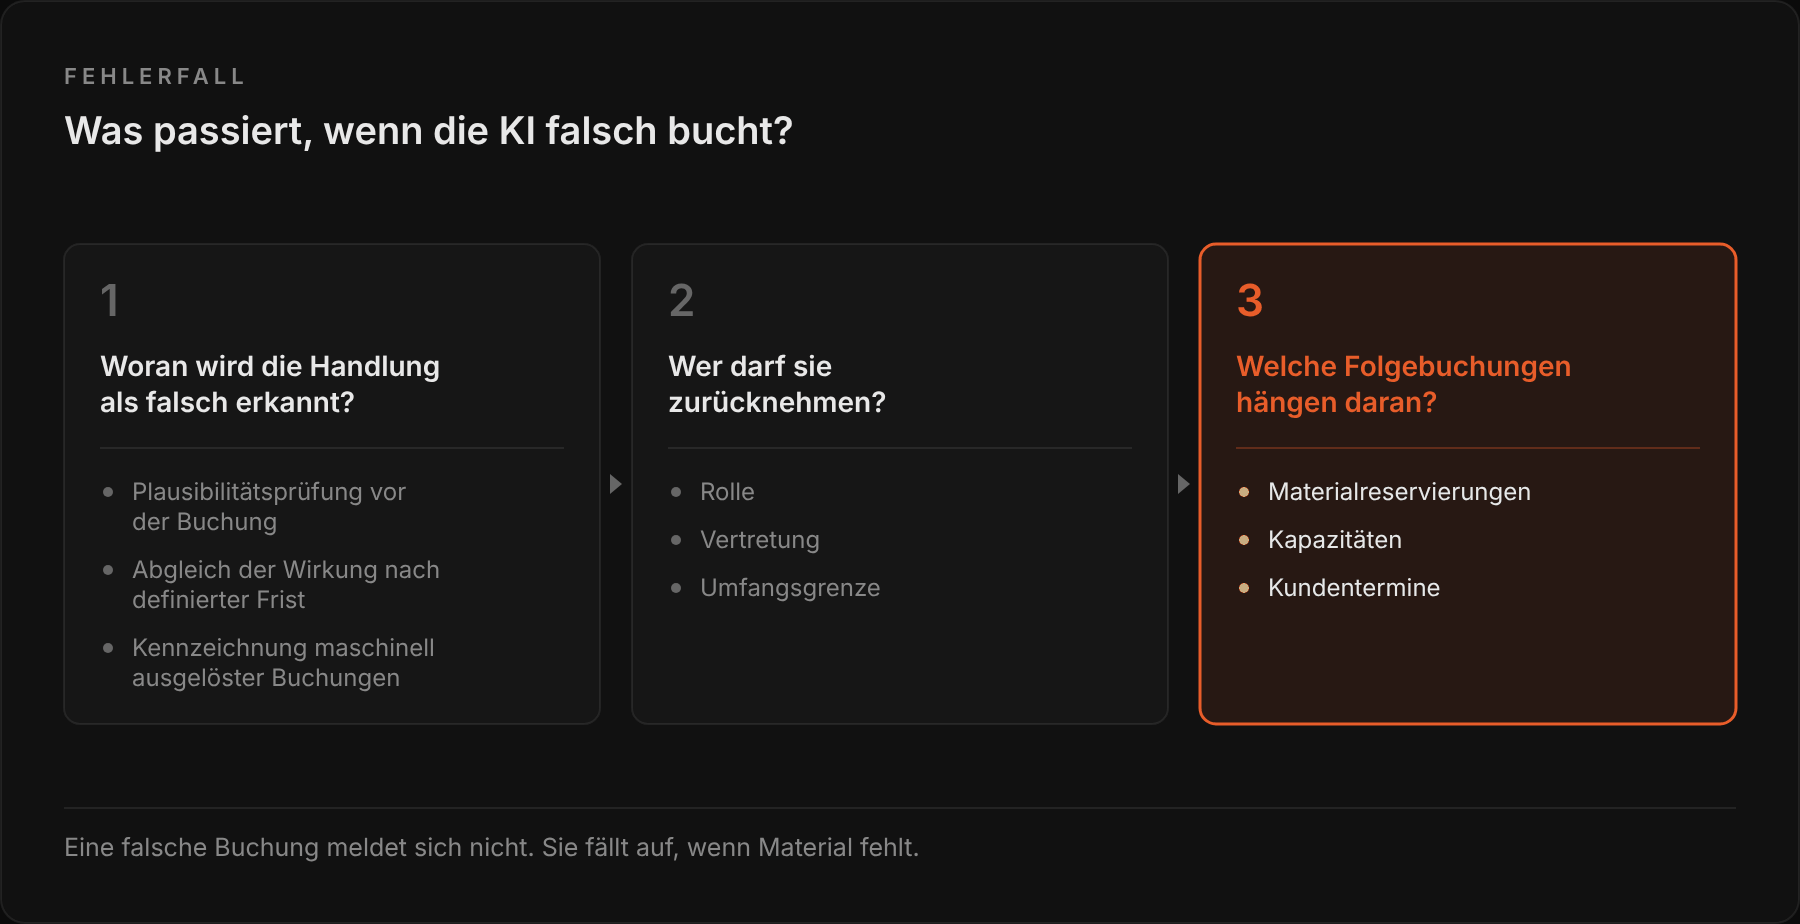
Rückrollpfad. Was passiert, wenn die KI falsch bucht. Diese Frage wird in Integrationsprojekten fast nie gestellt und entscheidet doch, ob eine Organisation Grad 4 verträgt. Sie zerfällt in drei Teilfragen: Woran wird eine falsche Handlung erkannt, wer darf sie zurücknehmen, und welche Folgebuchungen hängen daran. In der Produktionsplanung ist die dritte die unangenehmste, weil ein verschobener Auftrag Materialreservierungen, Kapazitäten und Kundentermine mitbewegt. Ein Rückrollpfad, der nur den Auslöser zurücksetzt, ist keiner.
Am schwersten wiegt die Frage, woran eine falsche Handlung überhaupt erkannt wird. Eine falsche Buchung meldet sich nicht. Sie fällt auf, wenn drei Wochen später Material fehlt, und dann ist der Zusammenhang zur ursprünglichen Handlung längst nicht mehr offensichtlich. Deshalb gehört zu jeder schreibenden Kopplung eine Erkennungsregel, die nicht auf den Zufall wartet. Dazu zählen eine Plausibilitätsprüfung vor der Buchung und ein Abgleich der tatsächlichen mit der erwarteten Wirkung nach einer definierten Frist. Am wenigsten kostet und am meisten hilft aber eine simple Kennzeichnung, die jede maschinell ausgelöste Buchung im System als solche erkennbar macht. Sie macht im Streitfall die Rekonstruktion überhaupt erst möglich.
Betriebsverantwortung. Wer betreibt die Schnittstelle in zwei Jahren. Dass diese Frage zum System gehört und nicht zum Projektende, ist normativ hinterlegt: ISO/IEC 5338 führt Betrieb, fortlaufende Validierung und Wartung von KI-Systemen als eigenständige Prozesse des Lebenszyklus. Integration ist damit kein Projekt mit Abschlussbericht, sondern ein Zustand mit Zuständigkeit. Das spricht nicht gegen einen kleinen Anfang: Ein einzelner Kernprozess braucht typischerweise eine entscheidungsbefugte Person, eine IT-verantwortliche und wenige Ansprechpartner aus dem Fachbereich. Es spricht aber dafür, Dokumentation und Übergabe von Beginn an als Teil des Umfangs zu behandeln, damit der Betrieb später intern getragen werden kann.
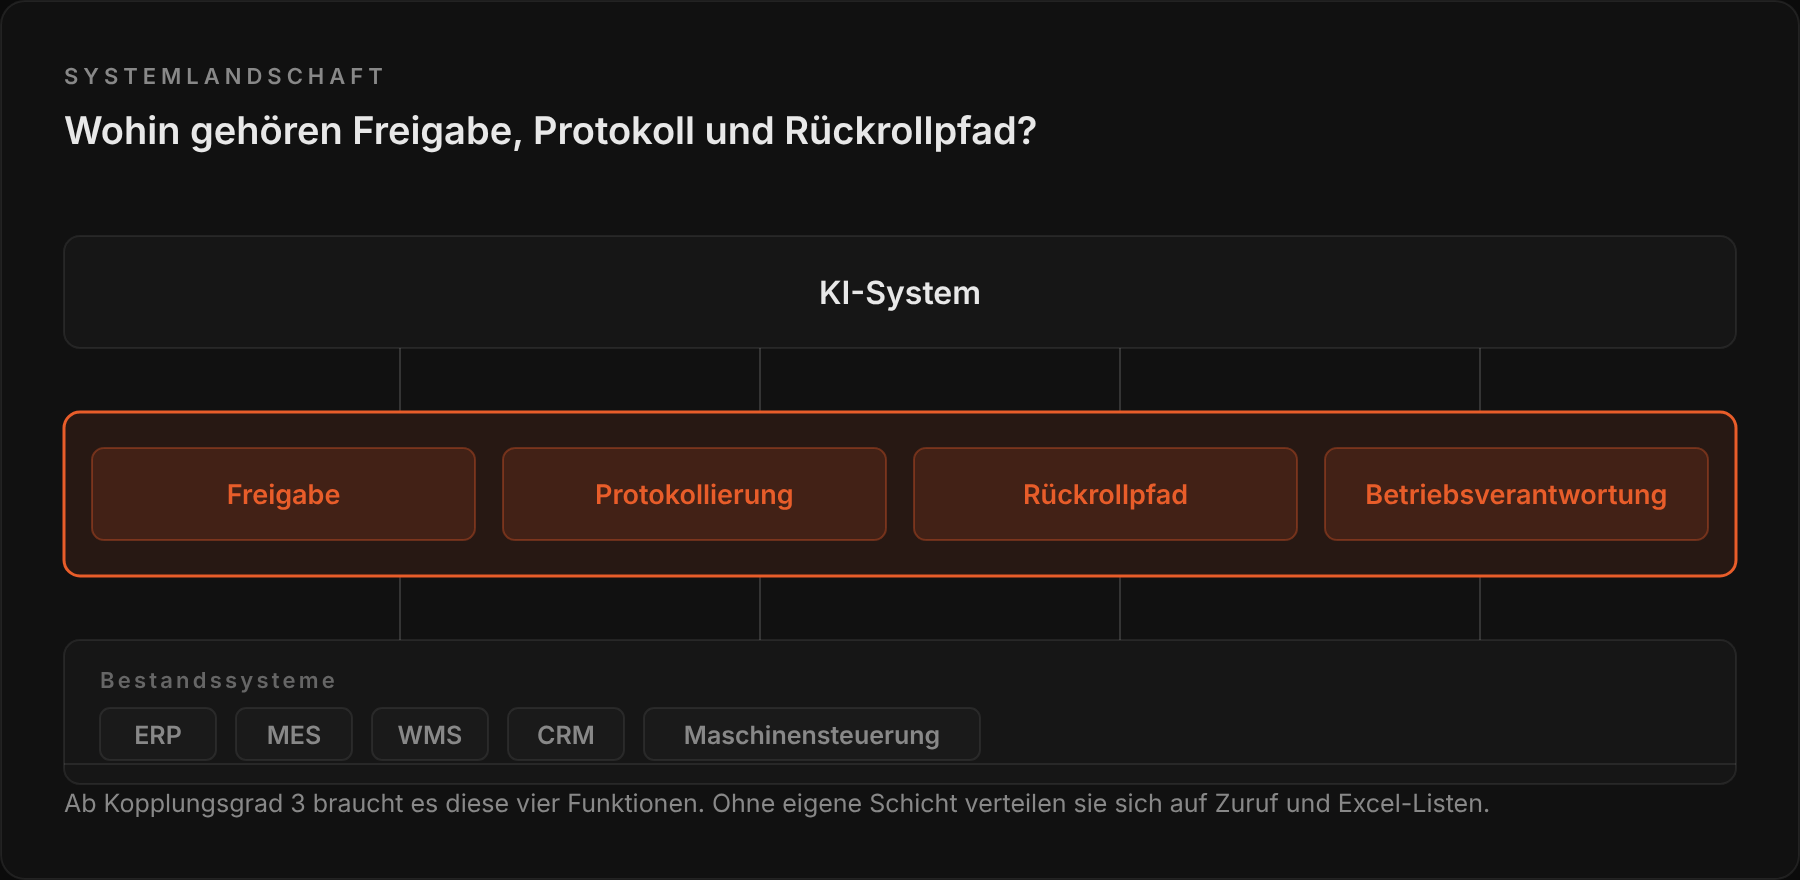
Diese vier Bausteine haben eine Gemeinsamkeit, die in Integrationsprojekten oft übersehen wird. Keiner von ihnen gehört in das KI-System, und keiner gehört in das ERP. Freigabelogik, Protokoll, Rückrollpfad und Betriebsverantwortung liegen zwischen beiden. Eine eigene Schicht ab Kopplungsgrad 3 ersetzt kein System. Sie hält diese vier Funktionen an einer Stelle zusammen, statt sie auf Zuruf und Excel-Listen zu verteilen.
AIOP · VON HANISCH CONSULTING
Agentic Industrial Orchestration PlatformDer Planer bestätigt Vorschläge, die niemand protokolliert. Die Freigaberegel steht in einer Excel-Liste, der Rückrollpfad in keinem System. AIOP ändert das: eine Steuerungsschicht, die Freigabe, Protokoll und Rückrollpfad an einer Stelle hält.
Die Schicht liegt über ERP, MES und WMS und ersetzt keines davon. AIOP koordiniert Produktion, Einkauf und Instandhaltung in einem kontrollierbaren System, ohne ERP-Anpassung.
−58 %
Prozessfehlerrate im Schnitt nach 12 Monaten
−90 %
Dateneingabefehler durch zentrale Echtzeit-Pipelines
4 Wo.
Typische Time-to-Value vom Kickoff bis erste Agenten live
Phase 0, 2 Tage, kostenlos: Schriftliches ROI-Assessment für Ihr Unternehmen, bevor Sie eine Entscheidung treffen. Das Risiko liegt auf unserer Seite.
Bevor die erste Buchung produktiv läuft
Für den Übergang von Grad 3 auf Grad 4 gibt es ein Verfahren, das in der Fertigung vertraut ist: den Schattenbetrieb. Das System rechnet die Buchung vollständig aus, schreibt sie aber in eine Testinstanz statt ins produktive ERP, während die Freigabe durch den Planer weiterläuft. Nach einigen Wochen lässt sich vergleichen, wie oft beide zum selben Ergebnis kommen und woran es liegt, wenn sie es nicht tun. Der Fraunhofer-Leitfaden beschreibt dasselbe Muster für die Modellentwicklung, nämlich den Aufbau in einer Laborumgebung, in der uneingeschränkt experimentiert werden kann, und den Wechsel in den produktiven Betrieb erst danach.
Pilotprojekte helfen, den echten Mehrwert von KI zu testen, bevor eine großflächige Einführung erfolgt, und für eine schreibende Kopplung ist der Schattenbetrieb genau dieses Pilotprojekt. Danach folgen iterative Umsetzungen mit kontinuierlichem Monitoring: erst ein Prozess, erst der niedrigere Kopplungsgrad, eine Ausweitung erst, wenn die Wirkung gegen den Ausgangswert gemessen ist.
Dieser Vergleich beantwortet nebenbei eine Frage, die in Integrationsprojekten meist unausgesprochen bleibt. Planer und Disponenten fragen sich, was von ihrer Arbeit übrig bleibt, wenn ein System die Reihenfolge selbst setzt. Mitarbeiterwiderstände entstehen häufig aus der Angst vor Jobverlust, und in Integrationsprojekten hat diese Angst eine präzise Adresse: den Kopplungsgrad. Auf Grad 3 behält der Planer die Entscheidung. Auf Grad 4 gibt er sie ab und behält die Aufsicht über das Verhalten des Systems. Wer diesen Unterschied früh erklärt und im Schattenbetrieb zeigt, führt eine andere Diskussion als jemand, der ihn offenlässt.
Damit ist auch gesagt, wo Change Management in einem Integrationsprojekt ansetzt. Es baut Widerstände gegen technologische Veränderungen dort ab, wo es die Eingriffstiefe benennt, statt allgemein für die Technologie zu werben. Schulungen in Testumgebungen fördern das Lernen ohne Angst, und im Schattenbetrieb steht eine solche Umgebung ohnehin bereit. Vor allem aber müssen Führungskräfte KI-Projekte als strategische Initiative führen, was hier eine sehr konkrete Bedeutung hat: Der Kopplungsgrad ist eine Leitungsentscheidung über Verantwortung und keine Festlegung der IT. Die weiteren organisatorischen Stolpersteine einer KI-Einführung behandeln wir im Beitrag zur KI-Implementierung.
Regulatorisch gilt: Die KI-Verordnung ordnet KI-Systeme nach Risikoklassen ein, und für Hochrisiko-Systeme sieht sie Pflichten zur Protokollierung und zur menschlichen Aufsicht vor. Die meisten Anwendungen in der industriellen Planung und Disposition fallen nicht in diese Kategorie. Für sie sind dieselben Mechanismen keine Pflicht, aber die Voraussetzung dafür, einen Eingriff später nachvollziehen zu können.
Die Einordnung selbst ist nicht freiwillig, sie ist nur später fällig als lange geplant. Die Digital-Omnibus-Verordnung (EU) 2026/1744 hat den Geltungsbeginn der Hochrisiko-Vorschriften verschoben: auf den 2. Dezember 2027 für die in Anhang III genannten Anwendungen und auf den 2. August 2028 für Hochrisiko-Systeme in Produkten nach Anhang I. Danach riskieren Unternehmen Bußgelder, wenn sie ihre KI-Anwendungen nicht nach dem EU AI Act einer Risikoklassifizierung unterziehen, denn ohne diese Einstufung lässt sich nicht belegen, dass eine Anwendung außerhalb der Hochrisiko-Klasse liegt. Welche Anwendungen betroffen sind und welche Bußgeldrahmen gelten, ordnen wir im Beitrag zur KI-Verordnung ein.
Für ein Integrationsvorhaben, das heute startet, ist die Verschiebung keine Entlastung. Ein Kopplungsgrad, den Sie jetzt festlegen, läuft im Dezember 2027 noch, und die Einstufung nachzuholen ist ungleich teurer, wenn die Schnittstelle bereits produktiv schreibt.
Interessant ist die Verordnung an dieser Stelle aus einem anderen Grund. Sie beschreibt genauer als die meisten Projekthandbücher, was Aufsicht betrieblich bedeutet. Artikel 14 der Verordnung (EU) 2024/1689 wird für Hochrisiko-Systeme verlangen, dass die aufsichtführende Person in der Lage ist, die Ausgabe des Systems außer Acht zu lassen, außer Kraft zu setzen oder rückgängig zu machen, und den Betrieb über eine Stopptaste oder ein ähnliches Verfahren zu unterbrechen. Artikel 26 wird vom Betreiber verlangen, die Aufsicht Personen zu übertragen, die über die erforderliche Kompetenz, Ausbildung und Befugnis verfügen. Beide Vorschriften stehen in Kapitel III und gelten deshalb erst ab den oben genannten Terminen.
Das dritte Wort ist das entscheidende. Kompetenz und Ausbildung lassen sich einkaufen. Befugnis muss die Organisation vergeben, und genau daran scheitert Aufsicht in der Praxis am häufigsten: Der Mitarbeiter, der den Vorschlag der KI prüfen soll, darf ihn formal ablehnen und wird in der Bewertung daran gemessen, wie zügig die Aufträge durchlaufen. Wer eine Ausgabe folgenlos ablehnen kann, beaufsichtigt. Wer sich für jede Ablehnung rechtfertigen muss, nickt ab. Für Planungs- und Dispositionsanwendungen außerhalb der Hochrisiko-Klasse werden diese Anforderungen ohnehin nie zur Pflicht. Als Prüfliste für die eigene Freigaberegel sind sie trotzdem die beste verfügbare, und der spätere Geltungsbeginn ändert daran nichts. Wer eine Ausgabe nicht übersteuern kann, hat ein Betriebsproblem, unabhängig davon, ab wann ein Gesetz dasselbe verlangt.
Hinweis: Diese Einordnung ersetzt keine Rechtsberatung. Sie gibt den Stand nach der Digital-Omnibus-Verordnung (EU) 2026/1744 wieder, in Kraft seit dem 27. Juli 2026, und zeigt, welche Steuerungs- und Dokumentationsfragen Unternehmen organisatorisch klären sollten.
Wann Sie nicht integrieren sollten
Drei Konstellationen, in denen wir von einem Integrationsprojekt abraten.
Der Systemhersteller liefert die Funktion bereits. Wenn die benötigte Auswertung im vorhandenen ERP oder MES als Standardfunktion enthalten ist, kostet ein eigenes Integrationsprojekt Geld für ein Ergebnis, das bereits bezahlt ist. In diesem Fall ist der Systemanbieter der richtige Ansprechpartner, nicht ein Integrationspartner.
Für Grad 1 fehlt die Historie. Ohne belastbare Vergangenheitsdaten erkennt ein Modell keine Muster, sondern Rauschen. Nach unserer Projekterfahrung ist der Aufbau der Datenlage in solchen Fällen das eigentliche erste Vorhaben. Das ist Arbeit an Datenstrategie und Business Intelligence, und sie rechnet sich auch ohne KI. Die Kopplung kommt danach.
Für Grad 4 ist der Ausnahmefall nicht definiert. Wenn im Betrieb niemand sagen kann, welche Konstellation als Sonderfall gilt, kann kein System sie erkennen und keine Eskalation greifen. Dann bleibt Grad 3 die richtige Stufe, und zwar dauerhaft.
Was dieser Text nicht leisten kann, ist die Einordnung Ihres konkreten Falls. Ob eine bestimmte Auswertung in Ihrem ERP bereits enthalten ist, ob Ihre Historie für ein Modell reicht und ob Ihr Ausnahmefall beschreibbar ist, lässt sich nur an Ihren Systemen und Ihren Prozessen beantworten.
Sieben Fragen an jeden Anbieter, der Ihnen KI-Integration verkauft
- Welchen Kopplungsgrad setzt Ihr Angebot voraus, und welchen erreicht es am Ende?
- Schreibt das System in unser Kernsystem, und unter wessen Freigabe?
- Was genau wird protokolliert, und wo liegt das Protokoll?
- Wie sieht der Rückrollpfad aus, wenn eine ausgelöste Handlung falsch war, einschließlich der Folgebuchungen?
- Welche Änderungen an unseren Kernsystemen sind nötig, und welche davon sind Modifikationen?
- Wer betreibt die Schnittstelle nach der Abnahme, und was kostet dieser Betrieb?
- Welcher Anteil des Aufwands entfällt auf Integration und Datenaufbereitung, getrennt ausgewiesen vom Modell selbst?
Frage sieben trennt regelmäßig die Angebote. Der einmalige Aufwand für Integration und Datenaufbereitung und der laufende Betrieb sind die beiden Kostenblöcke, die in Angeboten am häufigsten fehlen und über die Wirtschaftlichkeit am stärksten entscheiden.
Zur Größenordnung kursieren mehrere Zahlen, die eine Einordnung verdienen. Verbreitet ist die Angabe, dass 30 bis 50 Prozent des Budgets bei Legacy-Integrationen auf die Datenbereinigung entfallen. Ebenso verbreitet ist der Verweis, laut McKinsey verbrächten Datenwissenschaftler einen Großteil ihrer Zeit mit Datenbereinigung, und die Prognose, laut Gartner planten viele Unternehmen, ihre KI-Investitionen bis 2026 zu erhöhen. Wir haben für diese drei Angaben keine Primärquelle mit Bezugsgröße, Erhebungszeitraum und Methodik gefunden. Sie stehen hier deshalb als das, was sie sind: verbreitete Behauptungen, die man kennen sollte, weil sie in Angeboten auftauchen, und die man nicht in die eigene Kalkulation übernehmen sollte.
Etwas besser steht es um eine vierte Angabe. Der Fraunhofer-Leitfaden geht davon aus, dass das Vorbereiten der Datengrundlage bis zu 80 Prozent des Aufwands von KI-Projekten ausmacht. Das Whitepaper Von Daten zu KI der Plattform Lernende Systeme nennt für Datenerfassung und Datenaufbereitung dieselbe Größenordnung. Beide Veröffentlichungen führen die Angabe allerdings auf dieselbe Fachpublikation aus dem Jahr 2019 zurück, und beide formulieren sie als Schätzung. Zwei Nennungen sind hier also eine Nennung.
Wir verwenden die Zahl deshalb nicht als Planungsgröße. Sie taugt als Warnung und als Argument dafür, sich den Posten im Angebot getrennt ausweisen zu lassen. Belastbar wird der Anteil erst durch eine Sichtung Ihrer eigenen Datenlage, und das ist überschaubarer Aufwand, weil die Frage sich auf die wenigen Felder beschränkt, die das Vorhaben tatsächlich braucht.
Diese sieben Fragen sind nicht auf fremde Anbieter gemünzt. Stellen Sie sie uns genauso.
KI-INTEGRATION · ANBIETERGESPRÄCH
Diese sieben Fragen sind nicht auf fremde Anbieter gemünzt. Stellen Sie sie uns genauso.
Das ist eine belastbare Grundlage.
Wenn Ihr Anbieter fünf oder mehr dieser Fragen ohne Umweg beantwortet, kennen Sie Eingriffstiefe, Freigabelogik und Betriebskosten. Offen bleibt dann meist nur Frage sieben, der getrennt ausgewiesene Anteil für Integration und Datenaufbereitung. Genau dort trennen sich die Angebote.
30 Min · Kostenlos · Unverbindlich
Der nächste Schritt
Die Frage ist nicht, ob KI an Ihre Systeme angebunden werden kann. In fast allen Fällen kann sie das. Die Frage ist, wie tief sie eingreifen soll, und was Sie vorher aufbauen müssen, damit dieser Eingriff nachvollziehbar bleibt.
Wenn Sie wissen wollen, welcher Kopplungsgrad zu Ihrem Betrieb passt und was der Weg dorthin konkret verlangt, sprechen wir darüber. Kostenloses Erstgespräch vereinbaren. 30 Minuten. Unverbindlich. Konkret.
FAQ · KI-INTEGRATION IN BESTEHENDE SYSTEME
Was ist der Unterschied zwischen KI-Integration und KI-Implementierung?
KI-Implementierung beschreibt die Einführung eines KI-Vorhabens als Projekt, von der Zieldefinition bis zum Betrieb. KI-Integration beschreibt den engeren Ausschnitt davon: die Ankopplung des Systems an vorhandene Software wie ERP, MES oder WMS. Sie legt fest, welche Daten fließen, in welche Richtung und welche Handlungen das System auslösen darf.
Muss ich mein ERP anpassen, um KI zu integrieren?
In den meisten Fällen nicht. Die Anbindung läuft über Schnittstellen, nicht über Eingriffe in den Systemkern. Für SAP S/4HANA Cloud ist das vom Hersteller dokumentiert: Modifikationen am Kern ordnet SAP in seinem Clean-Core-Ansatz der niedrigsten Compliance-Stufe zu und empfiehlt stattdessen entkoppelte oder upgrade-stabile Erweiterungen. Für andere ERP-Systeme gilt dieselbe Richtung, ohne dass sie dort in dieser Form dokumentiert wäre.
Darf eine KI selbst im ERP buchen?
Technisch ja, sobald eine schreibende Schnittstelle besteht. Betrieblich sollte das erst geschehen, wenn vier Dinge stehen: ein Ausgangswert, eine Zielkennzahl, eine Definition des Ausnahmefalls und ein Rückrollpfad einschließlich der Folgebuchungen. Fehlt eines davon, ist die Vorschlagsstufe die richtige Wahl.
Welche Schnittstellen braucht KI zu ERP, MES oder Maschinen?
Auf Anwendungsebene meist REST- oder SOAP-Schnittstellen der jeweiligen Systeme, häufig ergänzt um Middleware. Auf Maschinenebene ist OPC UA verbreitet, das über ein Informationsmodell auch die Bedeutung der übertragenen Werte mitliefert.
Was passiert, wenn die KI eine falsche Buchung auslöst?
Das hängt vollständig davon ab, was vorher definiert wurde. Ohne Protokollierung ist im Nachhinein nicht rekonstruierbar, welche Daten zur Handlung geführt haben. Ohne Rückrollpfad ist unklar, wer sie zurücknehmen darf und was mit den daran hängenden Folgebuchungen geschieht.
Welche Datenqualität braucht eine KI-Integration?
Der Praxisleitfaden des Fraunhofer IGCV beschreibt die Güte von Daten über Genauigkeit, Vollständigkeit, Konsistenz und Aktualität und nennt zusätzlich die Relevanz der erfassten Daten. Welches Niveau reicht, hängt am Kopplungsgrad. Für eine lesende Auswertung darf die Datenlage Lücken haben, solange sie bekannt sind. Für eine schreibende Kopplung gilt das nicht, weil dort jede Lücke zu einer Buchung wird, die jemand zurücknehmen muss.
Gilt die KI-Verordnung für eine KI im ERP?
Meist nicht als Hochrisiko-System. Planungs- und Dispositionsanwendungen fallen in der Regel nicht unter die Hochrisiko-Klasse, und die dortigen Pflichten zu Protokollierung und menschlicher Aufsicht gelten für sie dann nicht verbindlich. Hinzu kommt der Zeitpunkt: Die Digital-Omnibus-Verordnung (EU) 2026/1744 hat den Geltungsbeginn der Hochrisiko-Vorschriften auf den 2. Dezember 2027 beziehungsweise den 2. August 2028 verschoben. Die Anforderungen aus Artikel 14 und Artikel 26 taugen trotzdem schon jetzt als Maßstab für die eigene Freigaberegel, insbesondere die Anforderung, dass die aufsichtführende Person eine Ausgabe übersteuern darf und dazu auch befugt ist.
Welche Architektur eignet sich für die Integration von KI in bestehende Systeme?
Modulare und API-getriebene Ansätze minimieren das Risiko von Systemausfällen, weil sie das Zielsystem unverändert lassen und sich im Störfall einzeln abschalten lassen. Ab Kopplungsgrad 3 kommt eine Steuerungsschicht hinzu, die Freigabelogik, Protokollierung und Rückrollpfad an einer Stelle hält. Von Modifikationen am ERP-Kern raten die Systemhersteller selbst ab.
Warum entstehen Widerstände gegen KI-Projekte, und was hilft dagegen?
Mitarbeiterwiderstände entstehen häufig aus der Angst vor Jobverlust. In einem Integrationsprojekt hat diese Angst eine konkrete Adresse, nämlich den Kopplungsgrad: Auf Grad 3 behält der Mitarbeiter die Entscheidung, auf Grad 4 gibt er sie ab. Change Management wirkt hier, wo es diese Eingriffstiefe benennt. Schulungen in Testumgebungen fördern das Lernen ohne Angst, weil im Schattenbetrieb ohnehin eine Testinstanz bereitsteht.
Wie führt man eine schreibende KI-Kopplung ein, ohne das laufende Geschäft zu gefährden?
Über Schattenbetrieb. Das System rechnet die Buchung vollständig aus und schreibt sie in eine Testinstanz, während die Freigabe durch den Planer produktiv weiterläuft. Der Vergleich beider Ergebnisse über einige Wochen zeigt, ob die Kopplung trägt, und liefert die Grundlage für die Entscheidung über den nächsten Kopplungsgrad.
Wer betreibt eine integrierte KI-Lösung nach dem Projekt?
Diese Frage gehört vor den Projektstart, nicht danach. ISO/IEC 5338 führt Betrieb, fortlaufende Validierung und Wartung von KI-Systemen als eigenständige Prozesse des Lebenszyklus. Eine Integration ohne benannte Betriebsverantwortung ist unvollständig.
30 Min · Kostenlos · Unverbindlich
Quellen
- Statistisches Bundesamt: Gründe gegen die Nutzung von Technologien der künstlichen Intelligenz nach Beschäftigtengrößenklassen, 2025
- Hochrangige Expertengruppe für Künstliche Intelligenz der Europäischen Kommission: Ethics Guidelines for Trustworthy AI, Kapitel Human agency and oversight, 2019
- OPC Foundation: OPC Unified Architecture Part 1, Overview and Concepts
- SAP: How to Extend SAP S/4HANA Cloud the Right Way, Clean Core, August 2025
- Model Context Protocol: Spezifikation vom 28. Juli 2026
- ISO/IEC 5338:2023: Information technology, Artificial intelligence, AI system life cycle processes
- Fraunhofer IGCV und Mittelstand-Digital Zentrum Augsburg: Praxisleitfaden KI, Datenaufbereitung für KI-Anwendungen in der Qualitätssicherung, November 2024
- Plattform Lernende Systeme: Von Daten zu KI, Intelligentes Datenmanagement als Basis für Data Science und den Einsatz Lernender Systeme, 2020
- Konferenz der unabhängigen Datenschutzaufsichtsbehörden des Bundes und der Länder: Orientierungshilfe zu empfohlenen technischen und organisatorischen Maßnahmen bei der Entwicklung und beim Betrieb von KI-Systemen, Juni 2025
- Verordnung (EU) 2024/1689 über künstliche Intelligenz, Artikel 14 und Artikel 26
- Verordnung (EU) 2026/1744, Digital-Omnibus-Verordnung zur KI, Amtsblatt vom 24. Juli 2026
VERWANDTE THEMEN
KI-Implementierung in der Praxis
Das Vorhaben als Projekt, von der Zieldefinition bis zum Rollout. Der weitere Rahmen um die Integration.
Mehr erfahren SERVICEKI-Lösungen für Unternehmen
Wo eine KI-Lösung in der Systemlandschaft sitzen kann, in vier Ebenen geordnet.
Mehr erfahren WISSENWas ist ein KI-Agent
Systeme, die auf Kopplungsgrad 4 selbstständig handeln. Was sie können und was sie voraussetzen.
Mehr erfahren WISSENData Warehouse vs. Data Lake
Wo abgeleitete Kennzahlen aus Kopplungsgrad 2 technisch sinnvoll liegen.
Mehr erfahren
Die meisten Geschäftsführer kennen weder die Kosten noch die Ergebnisse ihrer KI-Projekte.
